Viral hari ini di kalangan pengembang kecerdasan buatan adalah langkah NVIDIA membuka model baru untuk agen otomatis. Perusahaan itu merilis Nemotron 3.5 Super VL pada 15 Oktober 2026. Model tersebut menyasar tugas yang harus membaca dokumen, grafik, gambar, dan video dalam satu alur kerja. Bobotnya bisa diunduh dan dipakai ulang oleh pengembang di luar ekosistem tertutup.
Viral Hari Ini: Nemotron 3.5 Super VL Dirilis
Pengumuman itu disampaikan melalui kanal resmi NVIDIA. Menurut perusahaan, Super VL dibangun bersama Nemotron Coalition yang melibatkan sejumlah laboratorium kecerdasan buatan global. Peluncuran ini melengkapi keluarga model terbuka NVIDIA yang sebelumnya lebih dikenal lewat seri Llama dan Nemotron generasi awal. Langkah ini menandai dorongan baru pada model terbuka berskala besar.
NVIDIA menyebut Super VL sebagai model agen terbuka tercepat di kelasnya. Klaim utamanya adalah kecepatan menyelesaikan tugas berulang pada alur kerja panjang. Tugas semacam itu biasanya dibutuhkan perusahaan untuk memproses ribuan berkas setiap hari. Rincian peluncuran diuraikan pada laman resmi NVIDIA Blog.
Model ini juga menyasar penggunaan yang lebih luas, bukan hanya pusat data. NVIDIA menyiapkan versi yang bisa berjalan di perangkat lokal bersama dua model Bolt. Dengan begitu, pengembang punya pilihan menyesuaikan ukuran model dengan perangkat yang tersedia. Pilihan itu penting karena biaya komputasi masih menjadi penghalang utama adopsi.
Iklan
Campus Commercial Park: rukost di kawasan kampus
C.CO Park menghadirkan kawasan ruko dan kost dalam satu gerbang, dirancang untuk mahasiswa dan penghuni sekitar kampus. Cocok untuk yang mencari aset produktif dengan pengelolaan kawasan yang tertata.
Spesifikasi: 120 Miliar Parameter, 12 Miliar Aktif
Super VL memiliki 120 miliar parameter total dengan 12 miliar parameter aktif per token. Arsitekturnya menggabungkan Mamba-2, mixture of experts, dan lapisan atensi. Setiap lapisan mixture of experts memuat 512 pakar terarah atau routed experts. Kombinasi itu dirancang menekan biaya inferensi tanpa mengorbankan kapasitas model.
Model ini memakai encoder visi C-RADIO beserta konektor bahasa dan visi. Panjang konteksnya mencapai satu juta token. Masukannya bisa berupa teks, gambar, dan video, sedangkan keluarannya teks. Spesifikasi teknis itu tercantum dalam kartu model di Hugging Face.
Satu Model untuk Teks, Gambar, dan Video
Kemampuan multimodal menjadi daya tarik utama Super VL. Model ini bisa memproses halaman web, mengekstrak teks, membaca grafik, lalu menyimpulkan temuannya. Hal serupa berlaku untuk berkas PDF dan dokumen kerja yang biasa diolah agen. Dengan satu model, pengembang tidak perlu memindahkan konteks antar sistem terpisah.
NVIDIA menyebut model ini cocok untuk agen yang bekerja berhari-hari hingga berminggu-minggu. Agen semacam itu perlu memahami instruksi, memakai alat, dan mengikuti kebijakan perusahaan. Tantangannya bukan hanya kecerdasan, tetapi juga konsistensi pada tugas panjang. Karena itu, efisiensi per token menjadi penentu biaya operasional.
Klaim Kecepatan dan Hasil Uji
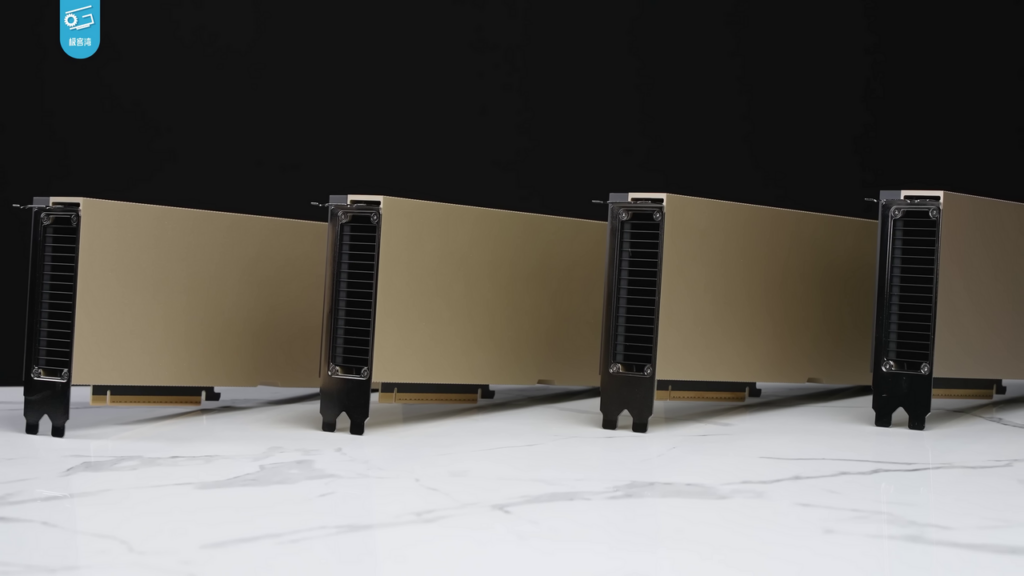
NVIDIA menyebut Super VL mampu menyelesaikan tugas agen sekitar lima kali lebih cepat dibanding model terbuka terbaik lain di kelas ukuran serupa. Lembaga penguji independen Artificial Analysis mengukur sekitar 625 token keluaran per detik pada empat GPU Blackwell B200 dengan masukan 100 ribu token. Angka itu dirangkum ulang oleh technology.org.
Pada uji dokumen dan grafik, perusahaan melaporkan skor 80,8 persen untuk tolok ukur CharXiv. Angka itu dibandingkan dengan 63 persen milik Nemotron 3 Nano Omni. Dengan interpretasi kode Python, skornya disebut mencapai 84 persen. Perusahaan juga mengklaim unggul atas Nemotron 3 Ultra pada beberapa evaluasi perilaku agen.
Model Bolt untuk Perangkat Lokal
Selain Super VL, NVIDIA memperkenalkan dua model Bolt berukuran lebih kecil. Nemotron 3.5 Bolt 74B-A9B 24GB dirancang menjalankan tugas agen harian di perangkat RTX dan DGX Spark. Model ini memakai kuantisasi 2-bit native agar muat dalam memori 24 GB. Ukuran itu memungkinkan model berjalan berdampingan dengan aplikasi lain.
Model kedua, Nemotron 3.5 Bolt E4B 4GB, dioptimalkan untuk agen percakapan cepat. Versi ini baru akan tersedia pada 23 Oktober 2026. Keduanya melengkapi pilihan dari server perusahaan hingga perangkat tepi. Strategi itu memperlihatkan NVIDIA tidak hanya membidik pasar pusat data.