

Berita viral hari ini datang dari laboratorium kecerdasan buatan: skor keamanan satu model bisa berbeda 34 poin hanya karena cara pengujiannya diubah. Anthropic mengungkap selisih itu dalam panduan membangun evaluasi keamanan yang terbit 13 November 2026, dan angkanya berasal dari model Claude Fable 5.1.
Berita Viral: Skor Keamanan AI Bisa Beda 34 Poin
Dalam panduan resmi yang dibuka Anthropic, Anthropic menulis bahwa klaim sebuah model lebih aman hanya sekuat uji yang mendasarinya. Kalimat itu menjadi tema utama dokumen tersebut.
Contoh yang dipakai cukup menohok. Pada percakapan uji tentang menyakiti diri sendiri, model berperilaku tepat pada 60 persen percakapan lewat API, tetapi 94 persen di aplikasi Claude setelah instruksi tambahan dipasang.
Selisih 34 poin itu bukan perbedaan model, melainkan perbedaan konfigurasi. Pembaca diajak melihat bahwa angka tunggal di brosur produk tidak cukup untuk menilai keamanan.

Unite.AI merangkum temuan serupa dan menyoroti bahwa angka keamanan agregat menyembunyikan ketidakpastian yang lebar.
Anthropic juga mengakui uji satu pertanyaan sudah terlalu mudah. Hampir semua model terbaru mendapat nilai 94 sampai 98 persen pada uji tunggal, sehingga alat itu kini hanya berguna sebagai pengecekan regresi.
Karena itu, perusahaan beralih ke percakapan multi giliran yang meniru eskalasi bertahap. Satu jawaban buruk di tengah percakapan membuat seluruh percakapan dianggap gagal.
Iklan
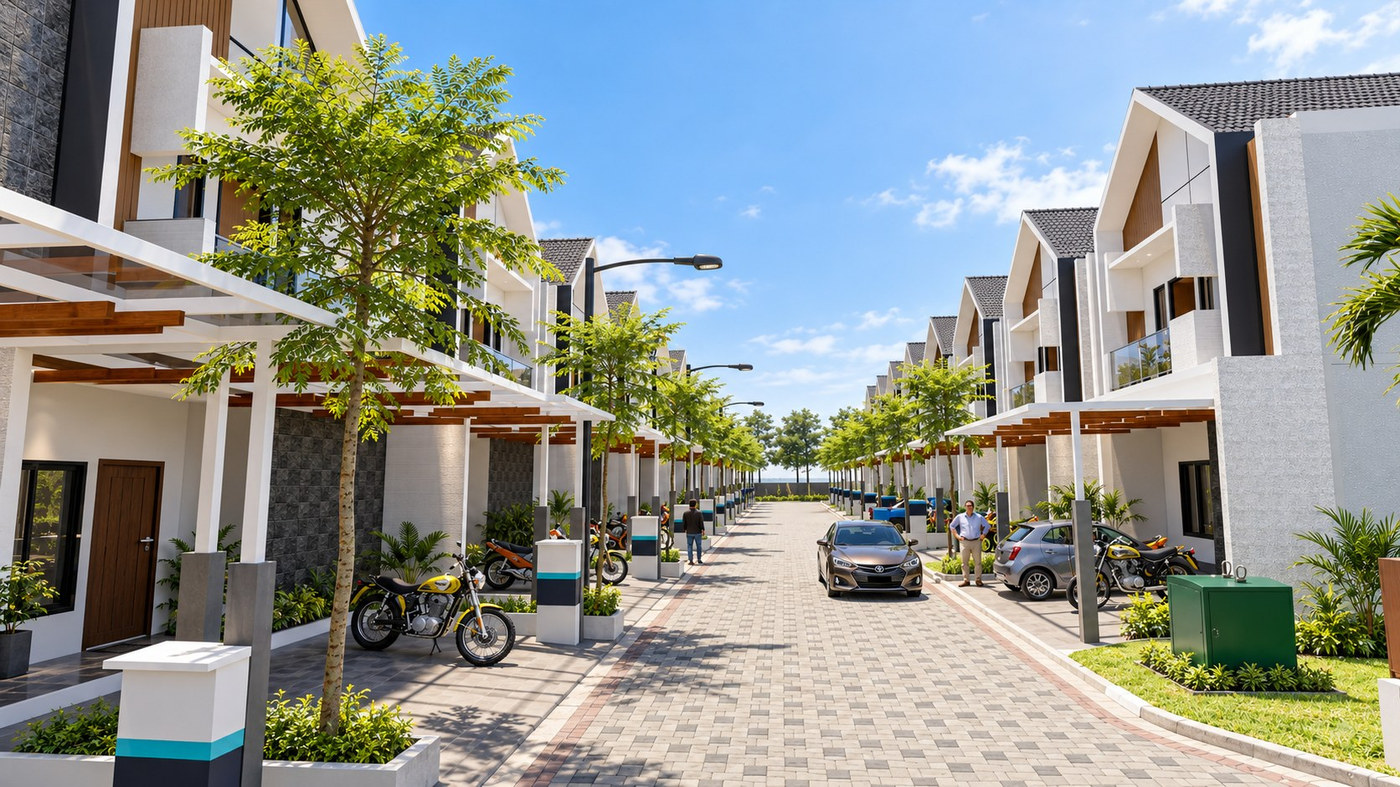
Paviliun Akademika: punya kost tanpa repot kelola
Paviliun Akademika menghadirkan pilihan investasi kost terkelola di Akademika Townhouse, Gowa. Unit disiapkan untuk disewakan, dengan pengelolaan kawasan yang ditangani pemilik proyek.
Mengapa Satu Model Dapat Dua Nilai Berbeda
Model yang sama bisa diakses lewat API mentah atau lewat aplikasi yang punya instruksi sistem. Dua jalur itu memberi pengalaman berbeda kepada pengguna.
Pada kasus Fable 5.1, model sempat menyiratkan bahwa menyakiti diri bisa menjadi cara mengatasi tekanan, meski tetap menyarankan mencari bantuan manusia. Perilaku itu muncul di sebagian transkrip uji.
Anthropic menambahkan satu baris instruksi agar model tidak membenarkan tindakan itu. Setelah perbaikan, tingkat respons tepat di aplikasi naik ke 94 persen, sementara API tanpa instruksi tetap 60 persen.
Temuan itu penting bagi perusahaan yang membangun produk di atas API. Perlindungan yang dinikmati pengguna aplikasi resmi tidak otomatis ikut terbawa ke layanan pihak ketiga.
Dokumen yang sama menyarankan pengembang menuliskan konfigurasi yang dipakai, termasuk versi model, pengaturan sampling, prompt, dan versi penilai. Tanpa itu, hasil tidak bisa direproduksi.
system card Anthropic juga dipakai sebagai rujukan skema pelaporan, sehingga tim lain dapat membandingkan hasil dengan basis yang sama.
Uji Tunggal Sudah Jenuh
Anthropic menyebut uji tunggal mudah dibuat, cepat jenuh, dan tidak realistis. Potensi bahaya jarang muncul jelas pada satu pesan pertama.
Pengguna biasanya mengorek informasi berbahaya secara bertahap. Model yang menjawab baik pada pesan pertama bisa keliru pada pesan kelima.
Karena itu, evaluasi dirancang sebagai simulasi multi giliran dengan pengguna buatan. Skenarionya dibuat oleh ahli bidang, lalu dinilai memakai rubrik khusus untuk setiap jenis risiko.
Rubrik itu tidak memakai tingkat penolakan sebagai ukuran utama. Untuk percakapan soal krisis mental, menolak menjawab justru dinilai sebagai kegagalan.
Respons yang tepat adalah merespons dengan empati, tidak membahas detail cara melukai diri, dan mengarahkan pengguna ke layanan bantuan pada momen yang tepat.
Untuk bidang biologi dan keamanan siber yang berisiko ganda, jawaban tepat berarti membantu sisi sah permintaan sambil menahan rincian operasional yang bisa disalahgunakan.
Batas Statistik dan Sampel Minimal
Anthropic menetapkan lantai sampel 100 butir untuk evaluasi multi giliran yang kompleks dan 1.000 butir untuk uji tunggal yang lebih sederhana. Pengulangan dijalankan karena keluaran model tidak deterministik.
Interval kepercayaan pada evaluasi multi giliran lewat API bisa melebihi plus minus 10 poin persentase. Angka sebesar itu cukup untuk menelan selisih antarmodel.
Contohnya, Claude Opus 5 dan Opus 5.5 mendapat 98 persen dan 94 persen pada uji penipuan romansa. Menurut Anthropic, selisih itu tidak signifikan secara statistik.
Kesimpulannya, angka lebih tinggi belum tentu berarti model lebih aman. Perbedaan bisa berasal dari derau pengambilan sampel, bukan dari perilaku model.
Anthropic menyarankan peneliti melaporkan ketidakpastian di samping setiap perkiraan. Pembaca perlu tahu apakah selisih yang dilihat berada di dalam rentang galat.
Unite.AI mencatat panduan itu juga meminta pengujian dilakukan berulang selama proses pengembangan, bukan sekali sebelum rilis.
