Berita viral dari dunia kesehatan datang lewat sebuah studi yang diterbitkan jurnal Science pada 22 Oktober 2026. Sistem diagnosis buatan Microsoft, MAI-DxO, menjawab benar 83,2 persen dari 304 kasus kompleks yang diambil dari rekam kasus New England Journal of Medicine. Dokter umum dalam studi yang sama hanya mencapai 36,1 persen ketika memakai buku rujukan dan internet.
Angka itu langsung menyebar di media sosial karena terasa seperti duel langsung antara mesin dan manusia. Sebagian warganet menyebutnya awal era dokter digital. Sebagian lain mengingatkan bahwa pengujian dilakukan dalam simulasi, bukan di ruang gawat darurat sungguhan.
Yang menarik, sistem ini tidak menjawab dalam satu tembakan. Ia bekerja seperti panel dokter yang saling berdebat. Setiap agen mengajukan pertanyaan, memilih pemeriksaan, lalu memperbarui dugaan berdasarkan hasil yang masuk sebelum mengambil kesimpulan akhir.
Berita Viral: Angka 83 Persen dan 36 Persen
Studi berjudul Sequential diagnosis with language models itu menguji 304 kasus NEJM yang diubah menjadi sesi diagnosis bertahap. Setiap peserta, baik model maupun dokter, bisa bertanya, meminta uji laboratorium, dan mempertimbangkan biaya. Penilaian dilakukan dengan rubrik yang disusun dokter.
MAI-DxO yang dijalankan dengan model GPT-5 mencapai akurasi 83,2 persen pada skenario tanpa batas biaya. Rata-rata biaya pemeriksaan yang dihabiskan sekitar 5.430 dolar per kasus. Ketika memakai gabungan beberapa model, akurasinya naik menjadi 84,5 persen.
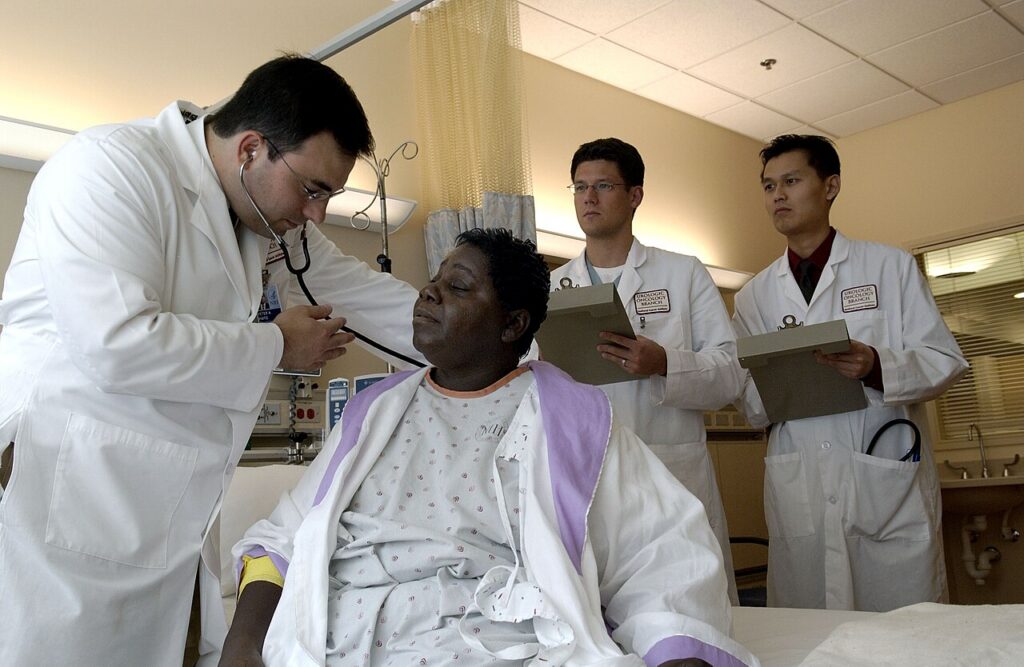
Dokter umum yang ikut serta mencatat 36,1 persen saat memakai buku dan internet. Tanpa bantuan rujukan, akurasi mereka turun ke 22,3 persen. Peserta terbaik di antara dokter mencapai 51,8 persen, masih jauh di bawah sistem otomatis tersebut.
Iklan
Paviliun Akademika: punya kost tanpa repot kelola
Paviliun Akademika menghadirkan pilihan investasi kost terkelola di Akademika Townhouse, Gowa. Unit disiapkan untuk disewakan, dengan pengelolaan kawasan yang ditangani pemilik proyek.
Metode Panel Agen yang Meniru Tim Dokter
Pendekatan MAI-DxO berbeda dari model bahasa biasa yang diminta menjawab sekali jalan. Sistem ini memecah proses diagnosis menjadi beberapa peran. Ada agen yang bertugas menggali riwayat pasien, ada yang mengusulkan pemeriksaan, dan ada yang menantang kesimpulan agen lain.
Setiap agen bekerja dengan anggaran biaya tertentu. Mereka memilih uji mana yang layak dilakukan lebih dulu, lalu memperbarui dugaan setelah hasil keluar. Di akhir proses, sistem melakukan pemeriksaan biaya dan verifikasi penalaran sebelum menetapkan diagnosis.
Microsoft menyebut pendekatan ini meniru cara kerja tim medis. Dokter tidak bekerja sendiri, melainkan berdiskusi dengan kolega dan spesialis. Dengan meniru pola itu, sistem bisa menghindari jalan pintas yang sering dipakai model tunggal.
Perbandingan pada Kasus Gawat Darurat
Selain kasus NEJM, peneliti menguji sistem pada data pasien gawat darurat dari basis MIMIC-IV-ED. Pada kelompok ini, akurasi MAI-DxO mencapai 80,3 persen. Angka pembanding untuk dokter berada di 46,79 persen.
Selisih pada kelompok gawat darurat lebih kecil dibanding kasus NEJM. Rasio akurasinya sekitar 1,7 kali, bukan 2,3 kali seperti pada kasus kompleks. Perbedaan ini menunjukkan keunggulan sistem mengecil ketika kasusnya lebih umum dan pola gejalanya lebih mudah dikenali.
Biaya pemeriksaan juga menjadi perhatian. Dengan anggaran lebih ketat, sistem masih mencapai 80,9 persen pada biaya 2.241 dolar dan 79,6 persen pada 1.303 dolar. Artinya, penurunan akurasi tidak sebanding dengan penghematan biaya yang diperoleh.
Kelemahan yang Harus Dibaca Sebelum Percaya
Kritik pertama menyangkut sifat pengujiannya. Semua angka berasal dari simulasi berbasis rekam kasus, bukan dari pasien sungguhan. Sistem tidak menangani tindak lanjut, komplikasi, atau keputusan pengobatan setelah diagnosis ditegakkan.
Kritik kedua menyangkut komposisi data. Sebanyak 248 dari 304 kasus NEJM disebut pernah dipakai dalam pengembangan sistem. Dokter peserta ujian tidak memiliki akses ke kasus yang sama sebelumnya. Perbandingan seperti ini rentan menimbulkan bias keuntungan bagi model.
Kritik ketiga menyangkut aturan bagi dokter. Peserta manusia dilarang memakai mesin pencari, model bahasa, dan sumber daring lain dalam sebagian skenario. Larangan itu membuat posisi dokter lebih sulit dibanding praktik sehari-hari, sehingga selisih angka perlu dibaca dengan hati-hati.
Konteks Penelitian Sebelumnya
Ini bukan pertama kali MAI-DxO diuji. Pada 2025, versi awal sistem dipublikasikan sebagai pracetak dan menarik perhatian luas. Saat itu, sistem dipasangkan dengan model o3 dan mencatat akurasi 85,5 persen pada 304 kasus yang sama.
Versi yang terbit di Science memakai GPT-5 dengan hasil sedikit lebih rendah. Perbedaan itu wajar karena model dan prosedur evaluasi mengalami penyesuaian. Yang berubah penting adalah status publikasinya: kini kajian itu sudah melewati penelaahan sejawat.
Meski begitu, status itu tidak menghapus keterbatasan metodologis. Penelaahan sejawat memeriksa kelayakan ilmiah, bukan menjamin bahwa sistem siap dipakai di rumah sakit. Microsoft sendiri menyebut penelitian ini sebagai demonstrasi riset, bukan produk komersial.