Viral Nusantara hari ini diwarnai rilis Carbon-X, model bahasa terbuka dari Hugging Face yang dirancang membaca dan menjelaskan sekuens DNA. Model ini diperkenalkan pada 22 Oktober 2026 dengan lisensi Apache 2.0. Bobotnya cukup kecil untuk dijalankan di satu kartu grafis 80 GB, bahkan di laptop melalui versi terkuantisasi.
Apa Itu Carbon-X
Carbon-X adalah model decoder-only berukuran 14,8 miliar parameter yang dilatih bersama oleh Hugging Face dan beberapa lembaga riset. Mitra yang tercatat di kartu model adalah Telethon Institute of Genetics and Medicine serta University of Naples Federico II di Italia, dan Zhongguancun Academy di Tiongkok. Model ini dibangun dari Qwen3-14B milik Alibaba sebagai titik awal.
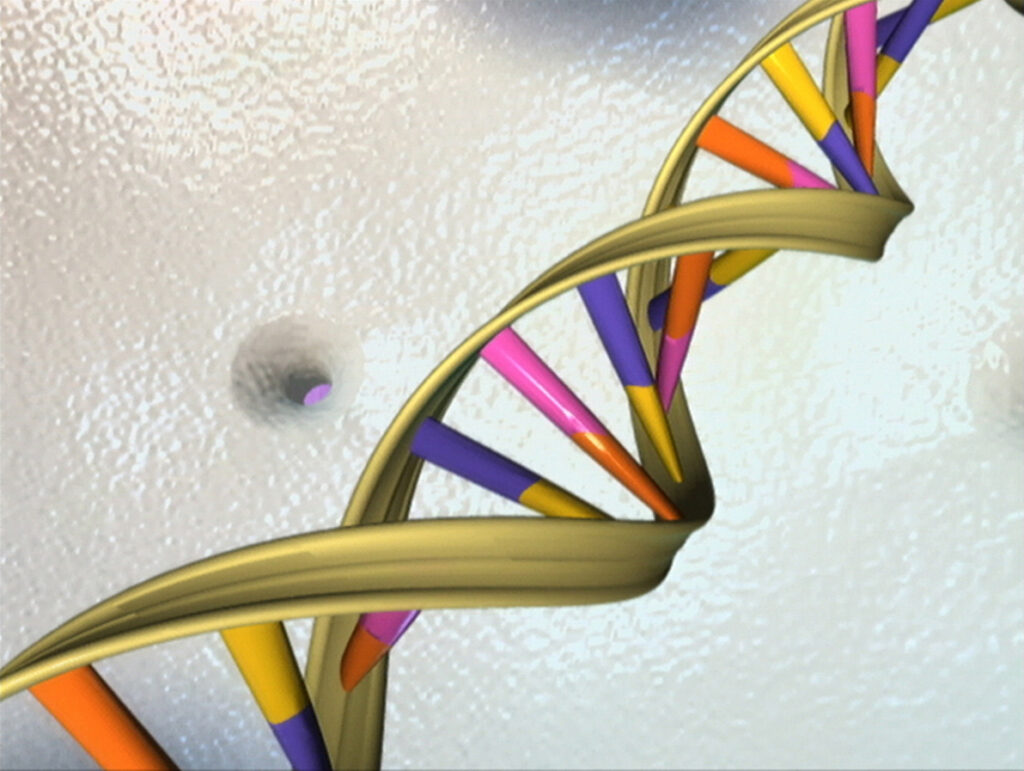
Pelatihan berlangsung pada 302 miliar token yang mencampur sekuens DNA, teks bahasa Inggris, dan materi biologi. Dengan campuran itu, model membaca kode genetik dan bahasa manusia dalam satu aliran. Pengguna bisa menempelkan DNA mentah ke dalam percakapan dan langsung bertanya, misalnya apakah sebuah mutasi berpotensi berbahaya.
WIRED menyebut model ini bisa berjalan lokal di laptop. Hugging Face juga merilis versi GGUF berukuran 9,6 GB untuk kuantisasi Q4_K_M. Artinya, laboratorium kecil bisa memakai model ini tanpa mengirim data ke server pihak lain.
Iklan
Campus Commercial Park: rukost di kawasan kampus
C.CO Park menghadirkan kawasan ruko dan kost dalam satu gerbang, dirancang untuk mahasiswa dan penghuni sekitar kampus. Cocok untuk yang mencari aset produktif dengan pengelolaan kawasan yang tertata.
Cara Kerja Token DNA
Carbon-X memakai tokenizer hibrida yang menyatukan kosakata teks dan DNA. Kosakata BPE dari Qwen3 dipakai untuk bahasa, sedangkan DNA dipecah menjadi potongan enam basa. Satu token DNA mewakili enam pasangan basa, sehingga urutan panjang bisa dipadatkan.
Total ada 5.515 token DNA, terdiri dari 4.096 kombinasi enam basa dan 1.364 token ekor. Token ekor dipakai saat panjang urutan bukan kelipatan enam. Model juga punya penanda khusus untuk awal dan akhir sekuens.
Jendela konteksnya mencapai 40.960 token. Namun pelatihan tahap menengah hanya memakai urutan 8.192 token, setara sekitar 49 ribu pasangan basa. Karena itu pengguna tidak bisa mengunggah genom manusia utuh, hanya potongan kecil untuk dianalisis.
Viral Nusantara: Mengapa Model Kecil Penting bagi Data Pasien
Viral Nusantara soal AI kesehatan sering berhenti pada klaim kecanggihan, padahal isu terbesarnya adalah kerahasiaan data. Rumah sakit dan laboratorium menghadapi batasan ketat saat mengirim data genetik ke model komersial. Model kecil yang bisa berjalan sendiri menjawab sebagian masalah itu.
Lewis Tunstall, peneliti senior Hugging Face, mengatakan tim sengaja merancang model 14 miliar parameter agar muat di perangkat pengguna. Dengan begitu, tidak ada data yang dikirim ke Hugging Face atau perusahaan lain. Bobot dalam format bfloat16 muat di satu GPU 80 GB.
Konsekuensinya, kualitas model berada di bawah model raksasa. Hugging Face menyebut Carbon-X sebagai titik awal untuk riset yang menghubungkan DNA dan bahasa. Mereka tidak memposisikannya sebagai pengganti pengujian laboratorium atau konsultasi medis.
Hasil Uji Internal dan Klaim Perusahaan
Pada tolok ukur DNA internal Hugging Face, Carbon-X mencetak rata-rata 66,7 persen. Angka pembanding untuk GPT-6.1 Sol adalah 67,5 persen pada upaya penalaran tertingginya. Selisihnya tipis, tetapi kedua angka berasal dari pengujian yang disusun Hugging Face sendiri.
Perusahaan juga menekankan biaya inferensi yang jauh lebih rendah. Perhitungan mereka memakai harga standar API dan throughput per jam GPU H200 seharga 5 dolar Amerika. Klaim penghematan itu belum diuji oleh pihak independen.
Pada tugas spesifik, model ini mengungguli pembanding di beberapa kategori, tetapi kalah di kategori lain. Hugging Face mempublikasikan rincian itu di kartu model Carbon-X. Sikap transparan semacam ini memudahkan peneliti lain memeriksa batas kemampuan model.
Yang perlu dicatat, tolok ukur DNA belum punya standar tunggal yang dipakai semua laboratorium. Perbandingan antar model sering memakai kumpulan data berbeda. Karena itu, selisih 0,8 poin persen tidak cukup untuk menyimpulkan keunggulan salah satu model.