
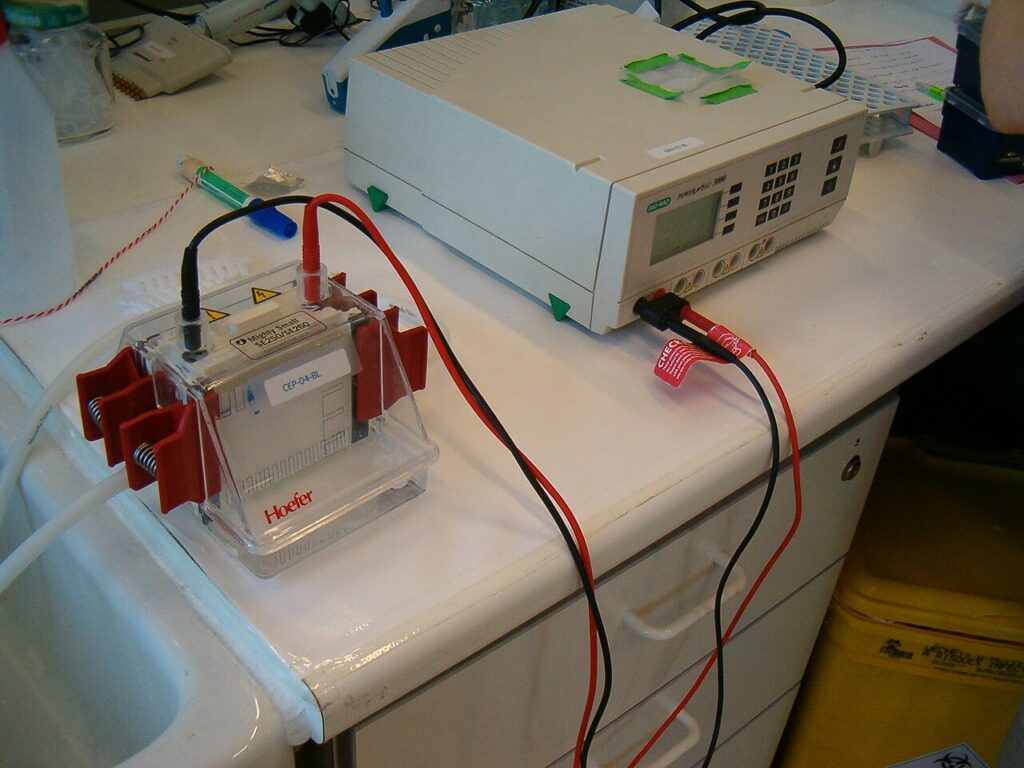

Berita viral dari dunia riset: OpenAI memperkenalkan BioBasicsBench, tolok ukur baru untuk menilai apakah agen kecerdasan artifisial mampu membaca data laboratorium basah yang masih mentah. Tolok ukur ini disusun bersama Ligo, perusahaan bioteknologi yang bergerak di bidang desain enzim. Pengumumannya dirilis pada 6 November 2026 melalui laman resmi OpenAI.
Berita Viral: AI Diuji Membaca Data Laboratorium Mentah
Selama ini, banyak uji kemampuan AI memakai grafik dan gambar yang sudah dipilih untuk keperluan publikasi ilmiah. Cara itu membuat model terlihat rapi, tetapi jauh dari kenyataan meja laboratorium. Eksperimen gagal, gambar buram, dan hasil yang saling bertentangan justru jarang masuk ke dalam uji semacam itu.
BioBasicsBench mencoba menutup jarak tersebut. Seratus tugas di dalamnya memakai bukti asli dari eksperimen, mulai dari citra gel, cawan koloni, mikroskopi, sampai berkas keluaran instrumen dan data sekuensing. Model diminta membaca hasil, menemukan kesalahan, dan mengaku bila bukti tidak cukup untuk menarik kesimpulan.
Kedua hal itu menjelaskan mengapa tolok ukur ini disusun dengan hati-hati, dan mengapa angka hasilnya perlu dibaca dengan sabar.

Iklan
Campus Commercial Park: rukost di kawasan kampus
C.CO Park menghadirkan kawasan ruko dan kost dalam satu gerbang, dirancang untuk mahasiswa dan penghuni sekitar kampus. Cocok untuk yang mencari aset produktif dengan pengelolaan kawasan yang tertata.
Seratus Tugas dari Eksperimen Nyata
Tugas-tugas itu tidak dikarang dari skenario imajiner. Ilmuwan Ligo mengubah data dari eksperimen mereka sendiri menjadi pertanyaan uji, lalu memasangkan setiap pertanyaan dengan rubrik penilaian yang ditulis pakar. Cakupannya lima bidang: metode protein, pencitraan dan sitometri, kuantifikasi dan uji, metode asam nukleat, serta kloning molekuler.
Menurut Unite.AI, tingkat kesulitannya beragam. Ada tugas sederhana seperti membaca berat molekul sampel DNA pada gel, ada pula analisis uji yang panjang. Sebagian tugas meminta angka, sebagian lain meminta penalaran, dan sebagian justru menilai apakah model berani menyatakan data belum memadai.
Jenis buktinya juga bercampur dalam satu tugas. Satu pertanyaan bisa memuat gambar gel, tabel hasil, catatan protokol, dan peta plasmid sekaligus. Kombinasi inilah yang mendekati pekerjaan harian di laboratorium, ketika satu keputusan diambil dari beberapa sumber bukti yang tidak selalu sejalan.
Tiga Lapis Tinjauan Sebelum Tugas Dipakai
Setiap tugas melewati tiga tahap pemeriksaan. Pertama, seorang ilmuwan Ligo yang tidak menulis tugas tersebut meninjau isinya. Kedua, ilmuwan bergelar doktor dari laboratorium lain melakukan tinjauan eksternal. Ketiga, tim internal melakukan pemeriksaan akhir atas pertanyaan, bukti, rubrik, catatan penulis, dan satu contoh jawaban model.
Prosedur berlapis itu menjaga agar angka yang keluar nanti tidak menyesatkan pembaca.
Penilaiannya memakai kredit parsial. Artinya, jawaban tidak dinilai benar atau salah secara mutlak, tetapi diberi poin sesuai kriteria yang terpenuhi. Dengan cara ini, penilai bisa membedakan kesimpulan yang tepat dari analisis yang hanya separuh benar.
Papan Skor: 66,7 Persen dan Jarak dengan Model Lain
OpenAI menguji tujuh modelnya sendiri: GPT-5.2, GPT-5.4, GPT-5.5, GPT-5.6 Sol, GPT-6.1 Sol, GPT-6 Luna, dan GPT-6 Astra. Uji mencakup 37 kombinasi model dan tingkat upaya penalaran, dengan lima percobaan untuk setiap tugas pada tiap kombinasi. Totalnya 18.500 hasil yang dinilai.
Pada tingkat upaya penalaran tertinggi yang dilaporkan untuk semua model, GPT-6 Astra memimpin dengan rata-rata 66,7 persen kredit tersedia. Rentang kepercayaan 95 persennya 60,3 sampai 73,1 persen. GPT-6.1 Sol menyusul di 62,0 persen, sedangkan GPT-5.6 Sol berada di 43,8 persen.
Menariknya, Astra mencapai angka itu dengan token keluaran jauh lebih sedikit, yaitu 4.704 per tugas, dibanding 9.099 pada GPT-5.6 Sol. Model lain berada lebih rendah: GPT-6 Luna 38,3 persen, GPT-5.5 35,4 persen, GPT-5.4 33,2 persen, dan GPT-5.2 31,2 persen. Pola ini menunjukkan perbaikan kemampuan multimodal, bukan sekadar penambahan waktu berpikir.
Di Mana Model Masih Salah
OpenAI tidak hanya memamerkan angka tertinggi. Perusahaan itu juga memublikasikan contoh kegagalan, dan bagian inilah yang paling informatif. Pada satu tugas PCR koloni, Astra membaca pola pita dengan benar, tetapi membalik tafsir yang didukung kontrol. Model memilih koloni yang masih membawa plasmid lama.
Pada tugas penghitungan koloni, Astra gagal memisahkan koloni yang berdekatan, melewatkan koloni yang terlihat, dan menandai agar kosong sebagai koloni. Hasilnya, jumlahnya kelebihan sekitar 12 persen dari acuan. Bila volume dan pengenceran tetap, kesalahan itu ikut membesarkan perkiraan efisiensi pemasukan DNA.
Ada pula contoh yang lebih halus. Ketika sel tampak keluar masuk bidang fokus, GPT-5.6 Sol mencari penjelasan biologis, sedangkan Astra mengenali bahwa gambar itu z-stack, yaitu rangkaian citra dari kedalaman berbeda. Perbedaan respons semacam ini menunjukkan bahwa membaca alat dan membaca biologi adalah dua keterampilan yang tidak selalu berjalan bersama.
