
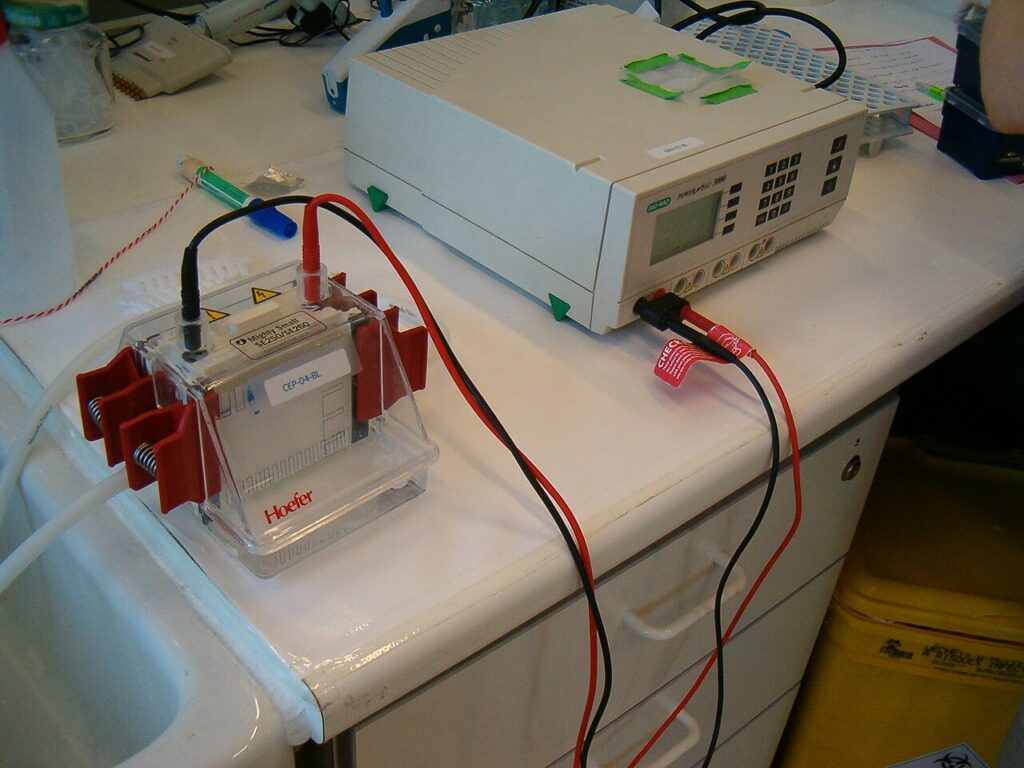

Mengapa Hasil Ini Penting untuk Sains
Laboratorium menghasilkan data jauh lebih cepat daripada kemampuan manusia membacanya. Bayangan tentang AI yang mempercepat penemuan obat sering melompati satu tahap: model harus lebih dahulu bisa dipercaya membaca hasil eksperimen rutin.
BioBasicsBench menempatkan tahap itu sebagai objek ukur. Bila kemampuan ini tercatat dari waktu ke waktu, ilmuwan bisa melihat apakah kemajuan model benar-benar berguna di meja kerja, bukan hanya di papan peringkat. Perusahaan juga bisa menilai kesiapan model untuk tugas pengawasan mutu.
OpenAI menyebut tolok ukur ini juga akan dipakai memahami implikasi keamanan hayati dan biosekuriti. Alasannya masuk akal: model yang makin piawai membaca data laboratorium juga makin mampu membantu pekerjaan yang sensitif. Pemantauan kemampuan karena itu berjalan seiring dengan pemantauan risiko, searah dengan pembahasan soal watermark pada keluaran model yang menandai jejak teks AI.
Di Indonesia, isu ini relevan bagi laboratorium kesehatan dan riset pangan. Banyak keputusan mutu diambil dari pembacaan gambar dan angka yang rutin. Model yang bisa membantu memeriksa kontrol dan menandai data janggal akan sangat berguna, asalkan batas kemampuannya dipahami.

Iklan
Campus Commercial Park: rukost di kawasan kampus
C.CO Park menghadirkan kawasan ruko dan kost dalam satu gerbang, dirancang untuk mahasiswa dan penghuni sekitar kampus. Cocok untuk yang mencari aset produktif dengan pengelolaan kawasan yang tertata.
Kritik dan Batas Klaim
Ada beberapa catatan yang perlu ditaruh di depan. Semua model yang diuji berasal dari satu perusahaan, sehingga hasilnya belum menjadi perbandingan antarpenyedia. Menurut R&D World, OpenAI hanya menguji modelnya sendiri dalam pengumuman ini.
Kedua, skor berupa kredit parsial tidak sama dengan tingkat keberhasilan tugas. Angka 66,7 persen berarti model mengumpulkan dua pertiga poin yang tersedia, bukan menyelesaikan dua pertiga tugas dengan sempurna. Perbedaan itu penting agar pembaca tidak menyimpulkan lebih jauh dari datanya.
Ketiga, soal-soal uji belum dibuka untuk publik. Tanpa akses ke butir tugas, peneliti lain sulit mereplikasi hasil secara langsung. Menurut AIAffairs, keterbukaan butir tugas akan menentukan apakah tolok ukur ini menjadi standar lapangan atau berhenti sebagai etalase satu vendor.
Apa yang Diketahui
BioBasicsBench berisi 100 tugas dari eksperimen nyata di lima bidang kerja laboratorium. Setiap tugas melewati tiga tinjauan dan dinilai dengan rubrik berkredit parsial, termasuk untuk pengakuan bahwa bukti tidak memadai. Pengujian mencakup tujuh model dan 37 kombinasi pengaturan, dengan total 18.500 hasil.
Pada pengaturan upaya penalaran tertinggi, GPT-6 Astra memperoleh 66,7 persen kredit tersedia dan GPT-5.6 Sol 43,8 persen. OpenAI juga mendokumentasikan kegagalan spesifik, seperti kesalahan memilih koloni dan kelebihan hitung sekitar 12 persen. Perusahaan menyatakan skor tinggi belum berarti model mampu memberi keputusan laboratorium yang andal.
OpenAI menyatakan tolok ukur ini akan dipakai melacak kemajuan analisis laboratorium rutin sekaligus menilai implikasi keamanan hayati. Pengumuman resminya dirilis pada 6 November 2026.
Apa yang Belum Terkonfirmasi
Belum ada hasil replikasi independen atas BioBasicsBench. Belum ada pula model dari perusahaan lain yang diuji dengan tolok ukur yang sama, sehingga klaim keunggulan baru berlaku di lingkup internal OpenAI.
Butir tugas belum tersedia untuk publik, dan belum ada keterangan apakah akan dibuka kemudian. Cara skor akan dipakai dalam kebijakan keamanan hayati juga belum dirinci. Begitu pula ambang skor yang dianggap cukup aman untuk membantu pekerjaan laboratorium tertentu.
Untuk pembaca di Indonesia, belum ada informasi apakah lembaga riset nasional akan memakai tolok ukur ini sebagai acuan. Pembahasan teknologi terjemahan luring seperti PLaMo 3 Translate menunjukkan hal serupa: kemampuan teknis cepat berubah, sedangkan kesiapan pengguna dan tata kelolanya bergerak lebih lambat.
FAQ BioBasicsBench
Apa itu BioBasicsBench?
Tolok ukur berisi 100 tugas dari eksperimen laboratorium basah nyata, disusun OpenAI bersama Ligo untuk menilai kemampuan agen AI membaca data mentah dan mengenali keterbatasan bukti.
Model mana yang memperoleh skor tertinggi?
GPT-6 Astra dengan 66,7 persen kredit tersedia pada pengaturan upaya penalaran tertinggi, diikuti GPT-6.1 Sol 62,0 persen dan GPT-5.6 Sol 43,8 persen.
Apakah skor tinggi berarti AI siap menggantikan analis laboratorium?
Belum. OpenAI sendiri menyatakan skor lebih tinggi tidak sama dengan penilaian laboratorium yang andal, dan tolok ukur ini masih mencatat kesalahan membaca kontrol serta kelebihan hitung koloni.
Baca juga
- Viral Nusantara: WhatsApp Bisa Undang Tamu Tanpa Akun
- Viral Hari Ini: 23 Pabrik Panel Surya di Batam Berhenti
- Berita Viral: Campak di AS Tembus 5.182 Kasus 2026
Kumpulan berita terbaru seputar berita Luwu Timur ada di kanal berita Luwu Timur.
