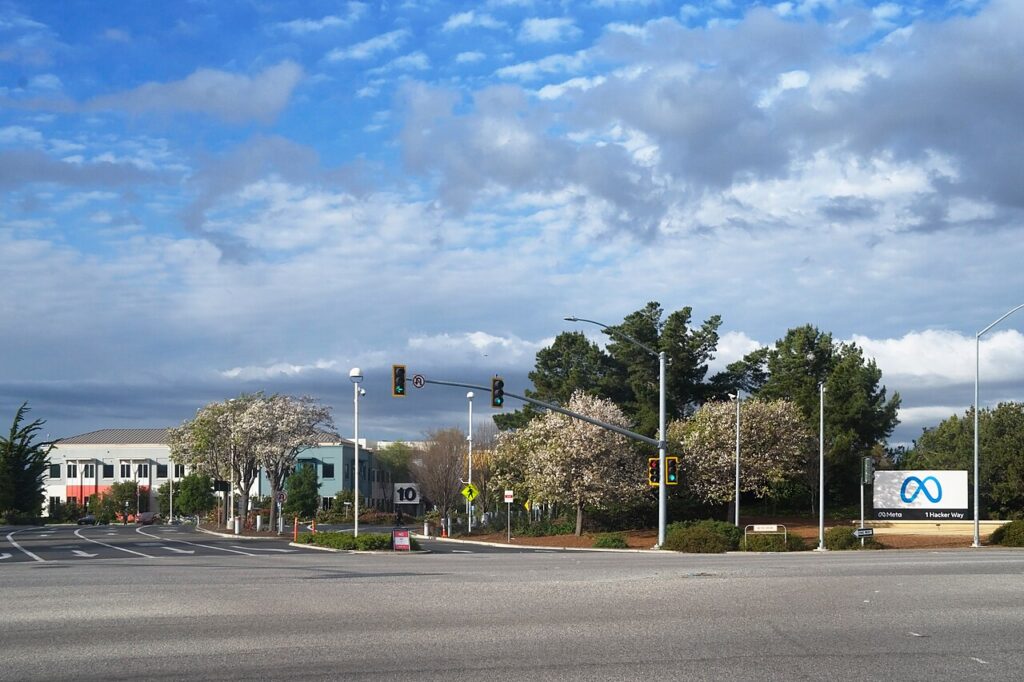
Viral hari ini di kalangan penerbit dan pekerja media: Meta menghapus satu klausul dalam ketentuan komersialnya yang dinilai membuka jalan bagi scraping situs berita. Klausul itu sempat memberi dasar bagi Meta untuk mengambil konten dari domain yang terkait akun bisnis dan memakainya untuk melatih produk kecerdasan buatan. Penghapusan terjadi setelah protes dari pakar hukum dan penerbit.
Viral Hari Ini: Klausul yang Memicu Protes
Perubahan ketentuan itu pertama kali diketahui dari pemberitahuan di Meta Business Suite pada awal Oktober 2026. Ketentuan baru dijadwalkan berlaku 30 Oktober 2026. Di dalamnya, Meta menyatakan dapat memakai perangkat lunak otomatis seperti web scraper, bot, dan crawler untuk mengakses domain, halaman web, atau URL yang terkait produk dan layanan pengguna bisnis.
Bunyi klausul itu juga menyebut Meta dapat memakai konten tersebut untuk menyediakan, mengembangkan, meningkatkan, meneliti, melatih, dan menjaga integritas produk serta layanan Meta. Frasa melatih atau train itulah yang memicu kekhawatiran. Sebab, ketentuan lain di Meta menjelaskan bahwa AI at Meta termasuk salah satu produk perusahaan.
Menurut Nieman Lab, tiga pakar hukum yang menelaah ketentuan itu menilai bahasa tersebut bisa dipakai untuk berargumen bahwa Meta boleh mengambil konten situs berita. Salah satunya adalah Matt Topic, pengacara media dan kekayaan intelektual di Loevy and Loevy. Ia menyebut klausul itu sebagai ketentuan yang luar biasa karena diletakkan dalam syarat layanan.
Iklan
Campus Commercial Park: rukost di kawasan kampus
C.CO Park menghadirkan kawasan ruko dan kost dalam satu gerbang, dirancang untuk mahasiswa dan penghuni sekitar kampus. Cocok untuk yang mencari aset produktif dengan pengelolaan kawasan yang tertata.
Mengapa Penerbit Merasa Dirugikan
Hampir setiap organisasi berita memiliki setidaknya satu akun bisnis di platform Meta. Akun itu dipakai mengelola halaman Facebook, profil Instagram, atau saluran WhatsApp. Karena itu, ketentuan yang menyangkut akun bisnis otomatis menyentuh hampir seluruh ruang redaksi.
James Grimmelmann, guru besar hukum digital dan informasi di Cornell Law School, menilai klausul itu memberi izin bagi Meta untuk melatih AI dengan konten penerbit. Bahkan, menurut dia, ada kemungkinan konten itu dipakai untuk bersaing dengan penerbitnya sendiri. Ia menyebut tafsir paling luas bisa menghasilkan arsip menyeluruh yang dipakai Meta sesuai kehendaknya.
Penerbit kecil merasakan tekanan paling besar. Mereka bergantung pada Facebook dan Instagram untuk mendatangkan pembaca. Stephen Beale, pendiri The Steampunk Explorer, mengaku mempertimbangkan menutup akunnya sebelum 30 Oktober. Ia menilai langkah Meta terasa arogan karena mengambil konten dari situs yang dibangun bertahun-tahun.
Tidak Ada Pilihan Menolak
Ketentuan itu tidak menyediakan opsi bagi akun bisnis untuk menolak sebelum tanggal berlaku. Teksnya menyatakan bahwa pengguna yang tidak setuju harus menghentikan seluruh akses atau penggunaan produk Meta untuk tujuan bisnis dan komersial. Dengan kata lain, pilihannya menerima ketentuan atau berhenti memakai platform.
Benjamin Sobel, guru besar hukum di University of Wisconsin, menyebut pola itu menyerupai konsep tying dalam hukum persaingan usaha. Jika ingin memakai produk Meta yang mensyaratkan persetujuan ketentuan komersial, pengguna juga harus menerima izin scraping. Ia membandingkannya dengan kebijakan Google yang meminta penerbit menyetujui penggunaan konten di AI Overviews agar tetap muncul di hasil pencarian.
Grimmelmann menambahkan bahwa ketentuan itu juga menyebut kemampuan membuat kredensial uji. Menurut dia, frasa tersebut secara teknis bisa dipakai untuk mendaftar sebagai pengguna palsu. Langkah itu berpotensi dipakai melewati dinding pendaftaran di situs penerbit yang membatasi akses konten.
Bantahan Awal Meta
Meta semula membantah bahwa ketentuan baru mengubah cara crawler bekerja. Juru bicara perusahaan menyatakan bahasa soal crawling sebelumnya tersebar di beberapa ketentuan, termasuk ketentuan penggunaan AI generatif dalam iklan. Pembaruan itu, menurut Meta, hanya menggabungkan bahasa tersebut di satu tempat.
Meta juga menegaskan bahwa pemilik konten tetap dapat mengatur akses melalui robots.txt. Berkas itu memang lazim dipakai untuk memberi tahu bot bagian mana dari situs yang boleh dan tidak boleh diakses. Namun, pakar hukum menilai bahasa baru dalam ketentuan komersial membuka ruang bagi Meta untuk berargumen bahwa persetujuan pengguna mengalahkan instruksi pemblokiran.
Meta menolak menjawab sejumlah pertanyaan Nieman Lab, termasuk soal apakah kredensial uji bisa menembus paywall. Perusahaan juga tidak merinci bagaimana ketentuan itu akan diterapkan pada konten berbayar. Ketidakjelasan itulah yang membuat penerbit menuntut penjelasan tertulis.